重庆企业数字化转型中大数据落地的三个关键环节
重庆制造企业的数字化改造,今年明显提速了。但一个尴尬的现实是:不少企业买了昂贵的BI工具、上了ERP系统,数据却依然躺在服务器里“沉睡”。问题不在技术,而在于落地路径的缺失——数据怎么采、怎么算、怎么用,这三个环节断了一个,所谓的大数据应用就成了摆设。
行业现状:数据“有而不通”是最大痛点
走访了渝北、两江新区的二十多家规上企业,我发现一个共性现象:生产线上的PLC(可编程逻辑控制器)数据、MES(制造执行系统)工单数据、ERP库存数据,各自为政。有的企业光数据库就装了四五种,接口协议五花八门。数据量看着不小,可真要提取某个订单的全链路信息,IT部门得手工导表,搞一整天。这种“数据孤岛”不打破,后续的智能开发就是空中楼阁。
关键一:网络搭建要“先通后快”
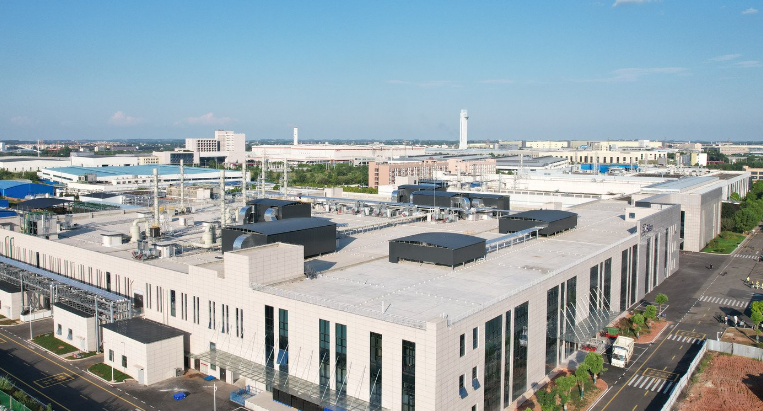
大数据落地的第一步,往往不是算法,而是网络搭建。重庆很多老厂区车间里,工业网线还是十年前布的,带宽和稳定性根本扛不住高频数据采集。我们给一家汽配厂做改造时,发现其车间内网延迟竟然高达200毫秒——这种环境下,任何实时分析都无从谈起。
所以别急着上昂贵的数仓,先把车间内网、边缘网关、云专线这三层基础捋顺。用TSN(时间敏感网络)技术替代传统以太网,配合5G CPE(客户终端设备)做无线补充,能把延迟压到10毫秒以内。这一步走扎实了,后续的数据治理才不至于返工。
关键二:数据治理与智能开发要“分步走”
网络打通之后,真正的硬骨头来了——数据清洗和特征工程。很多企业迷信AI,觉得买了算法平台就能自动产出洞察。实际上,重庆制造业的数据质量参差不齐:传感器偶尔丢包、工单字段填错、设备型号新旧混杂。这时候需要的是懂业务的数据工程师,而不是只会调参的算法工程师。
我们的做法是分三步:先做元数据梳理,建立统一的编码规范;再做流批一体处理,用Kafka(消息队列)接实时流,用Spark(计算引擎)跑离线批;最后才是模型训练。整个过程里,智能开发的核心不是模型多先进,而是特征工程与业务逻辑的匹配度。比如预测设备故障,与其用复杂的深度学习,不如先把振动、温度、电流三个维度的阈值规则摸透,效果反而更稳定。
选型指南:别被“全家桶”绑架
现在很多云厂商推“一站式大数据平台”,听起来省心,但落地时往往水土不服。重庆企业选型,我建议盯住三点:第一,是否支持私有化部署——很多制造数据涉及工艺参数,不能全上公有云;第二,是否兼容你们现有的数据库和接口协议,别为了用新平台把旧系统全部推翻;第三,服务商的本地化响应能力——出了问题能不能两小时内到场,这比产品宣传页上的参数重要得多。
以我们服务过的某摩托车发动机企业为例,他们没有选择大厂的通用方案,而是基于开源的Doris(分析型数据库)做定制,配合技术咨询团队梳理出12个核心业务指标。整个项目周期不到四个月,硬件投入比原方案省了40%。这就是“量体裁衣”的价值。
应用前景:从“看报表”到“做决策”
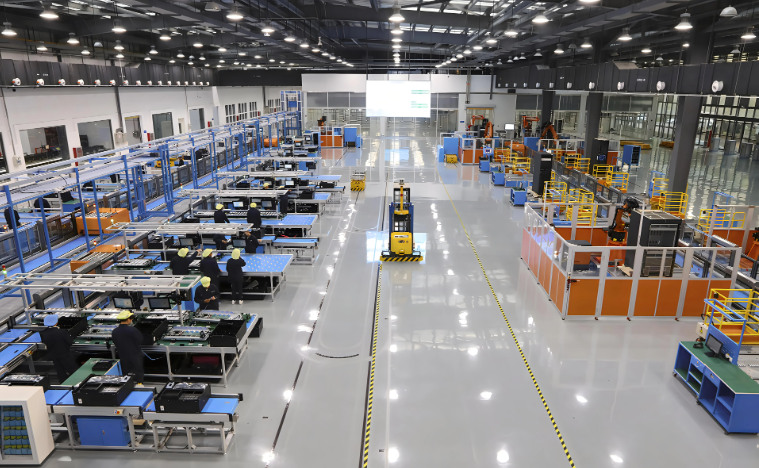
当数据真正流动起来,变化是肉眼可见的。还是上面那家汽配厂,现在通过实时监控注塑机参数,把废品率从3.1%压到了1.8%;排产系统结合订单预测,库存周转天数缩短了11天。这些不是科幻故事,而是重庆工厂车间里正在发生的日常。
不过也要清醒:数字化服务不是一次性交付,而是持续运营。数据模型需要随着业务调整不断迭代,网络架构也需要跟着产线扩展而升级。我们一直强调,企业要建立自己的数据运营小组,哪怕只有两三个人,也要把数据资产的维护权握在自己手里。未来的竞争,拼的不是谁的数据多,而是谁的数据用得更深、更准。